NLP自监督学习
NLP自监督学习
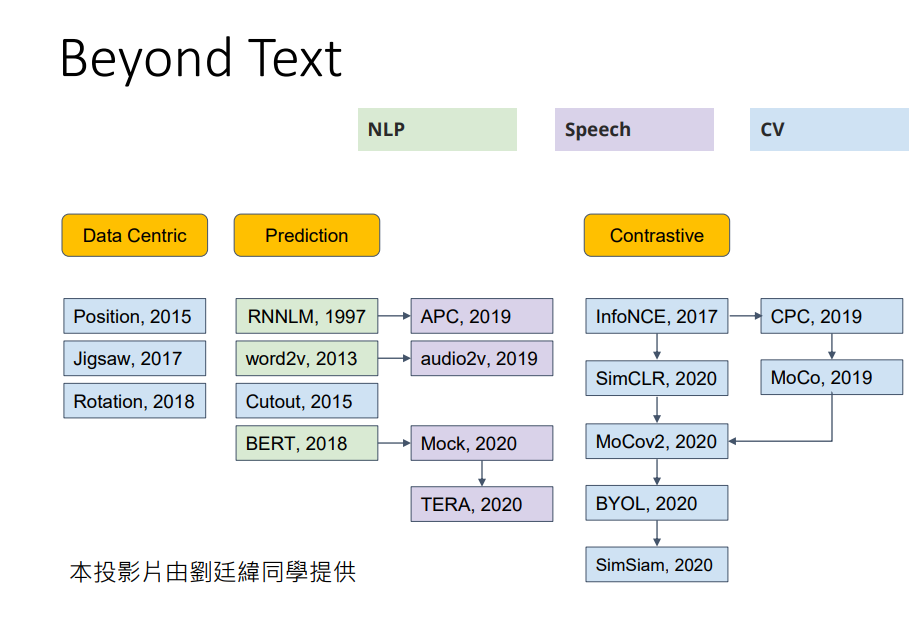
各种任务上都可以做
Self-supervised Learning
“自监督学习”数据本身没有标签,所以属于无监督学习;但是训练过程中实际上“有标签”,标签是“自己生成的”。把训练数据分为“两部分”,一部分作为作为“输入数据、另一部分作为“标注”。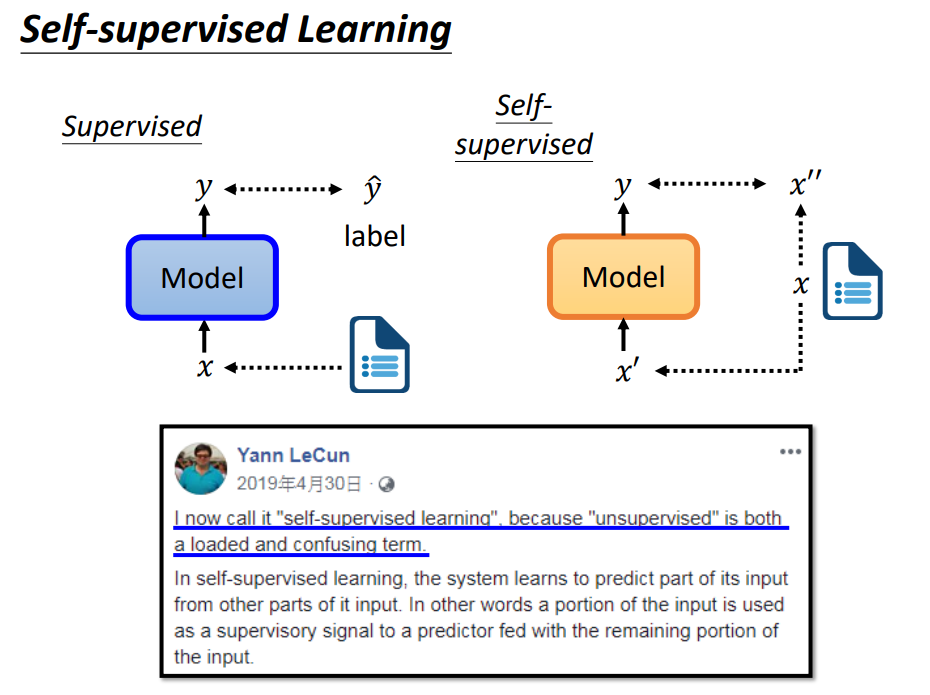
BERT
输入一排,输出一排,长度一致。输入换成语音也是一样的
BERT是一个transformer的Encoder,BERT可以输入一行向量,然后输出另一行向量,输出的长度与输入的长度相同。BERT一般用于自然语言处理,一般来说,它的输入是一串文本。当然,也可以输入语音、图像等“序列”。
作为transformer,理论上BERT的输入长度没有限制。但是为了避免过大的计算代价,在实践中并不能输入太长的序列。 事实上,在训练中,会将文章截成片段输入BERT进行训练,而不是使用整篇文章,避免距离过长的问题。
Masking Input
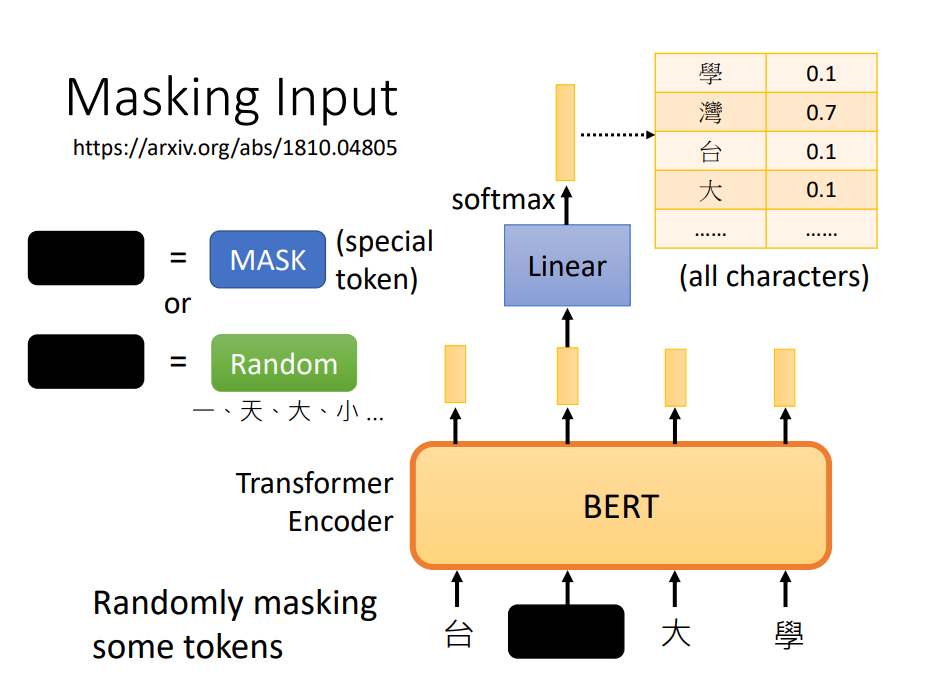
- 用一个特殊的符号替换句子中的一个词,用 “MASK “标记来表示这个特殊符号,把它看作一个新字,这个字完全是一个新词,它不在你的字典里,这意味着mask了原文。
- 另外一种方法,随机把某一个字换成另一个字。中文的 “湾”字被放在这里,选择另一个中文字来替换它,它可以变成 “一 “字,变成 “天 “字,变成 “大 “字,或者变成 “小 “字,随机选择的某个字来替换它
训练流程
向BERT输入一个句子,先随机决定哪一部分的汉字将被mask。
输入一个序列,我们把BERT的相应输出看作是另一个序列
在输入序列中寻找mask部分的相应输出,将这个向量通过一个Linear transform(矩阵相乘),并做Softmax得到一个分布。
用一个one-hot vector(独热编码)来表示MASK的字符,并使输出和one-hot vector之间的交叉熵损失最小。
下一条语句预测
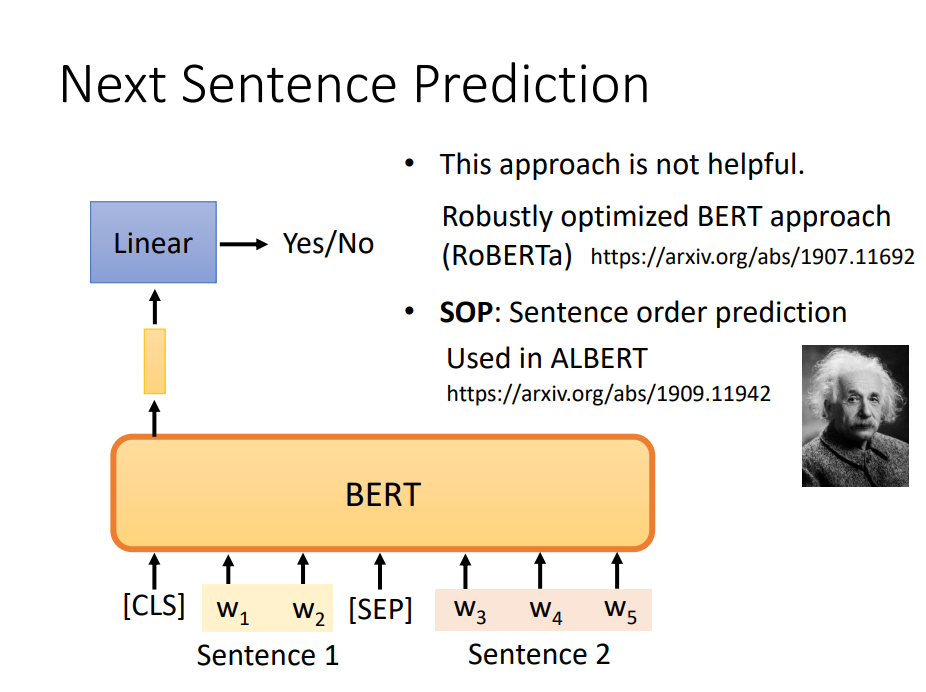
从数据库中拿出两个句子,两个句子之间添加一个特殊标记[SEP],在句子的开头添加一个特殊标记[CLS]。这样,BERT就可以知道,这两个句子是不同的句子。
通过CLS的输出,把它做一个Linear transform,输出yes/no,预测两句是否是相接的。
BERT的能力
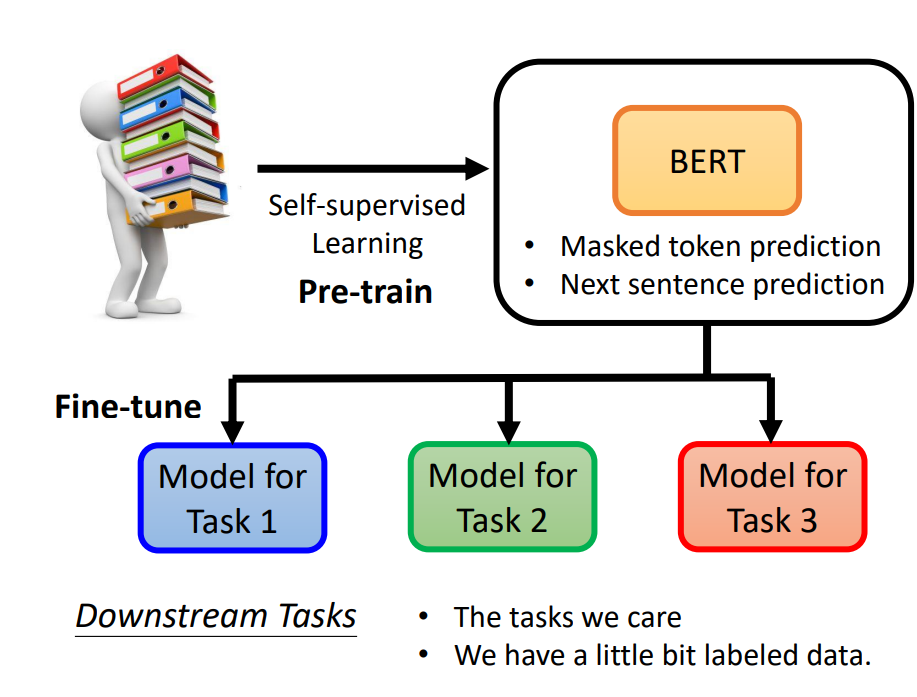
为了测试Self-supervised学习的能力,通常,会在一个任务集上测试它的准确性,取其平均值得到总分。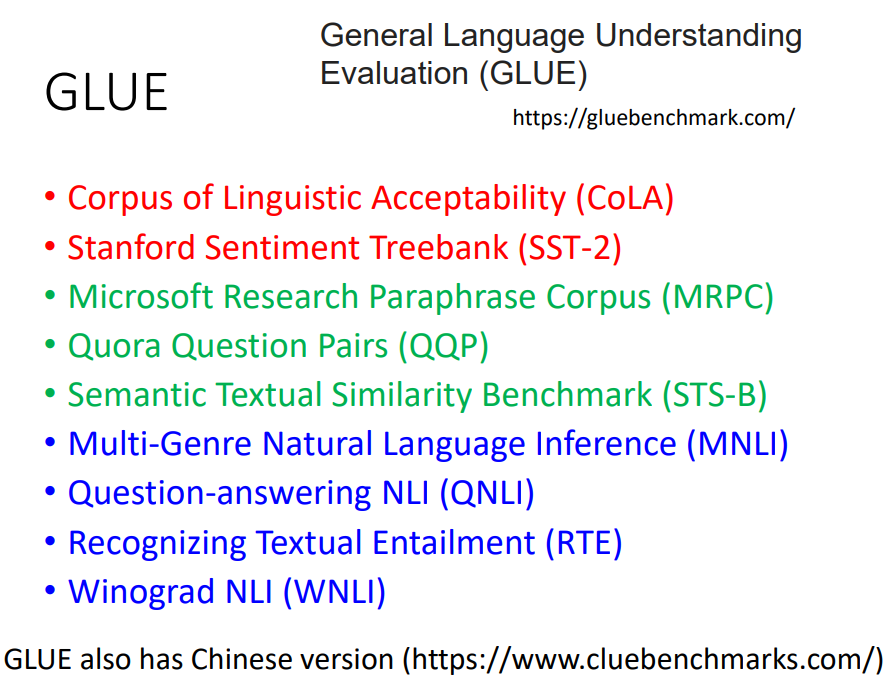
How to use BERT – Case 1
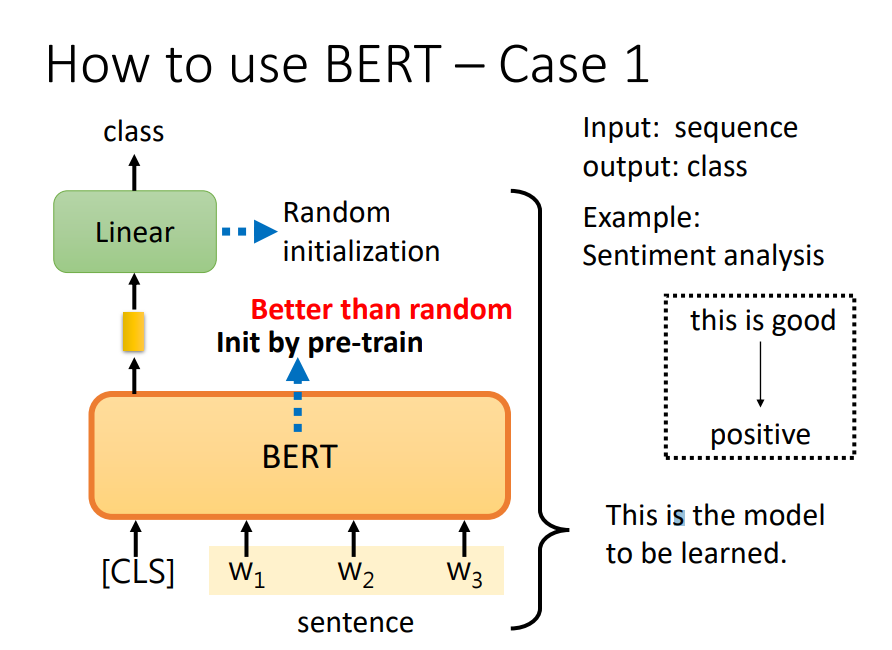
inear transform和BERT模型都是利用Gradient descent来更新参数,Linear transform的参数是随机初始化的,而BERT的参数是由学会填空的BERT初始化的
使用BERT的整个过程是连续应用Pre-Train+Fine-Tune,它可以被视为一种半监督方法(semi-supervised learning)
How to use BERT – Case 2
Input: sequence output: same as input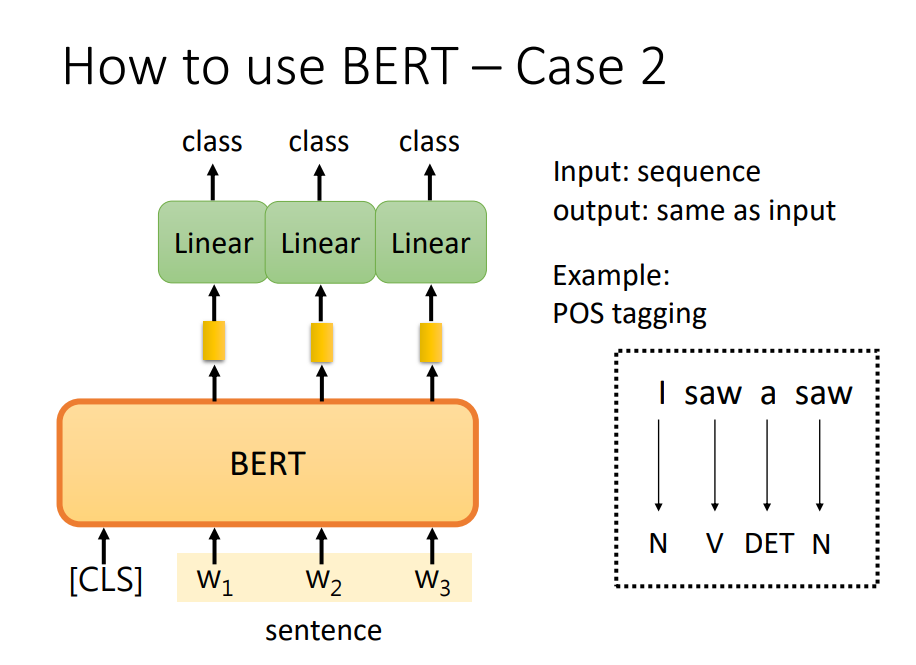
How to use BERT – Case 3
Input: two sequences
Output: a class
可以同样用作语音、图像上。给出前提和假设,机器要做的是判断,是否有可能从前提中推断出假设。⇒预测“赞成、反对”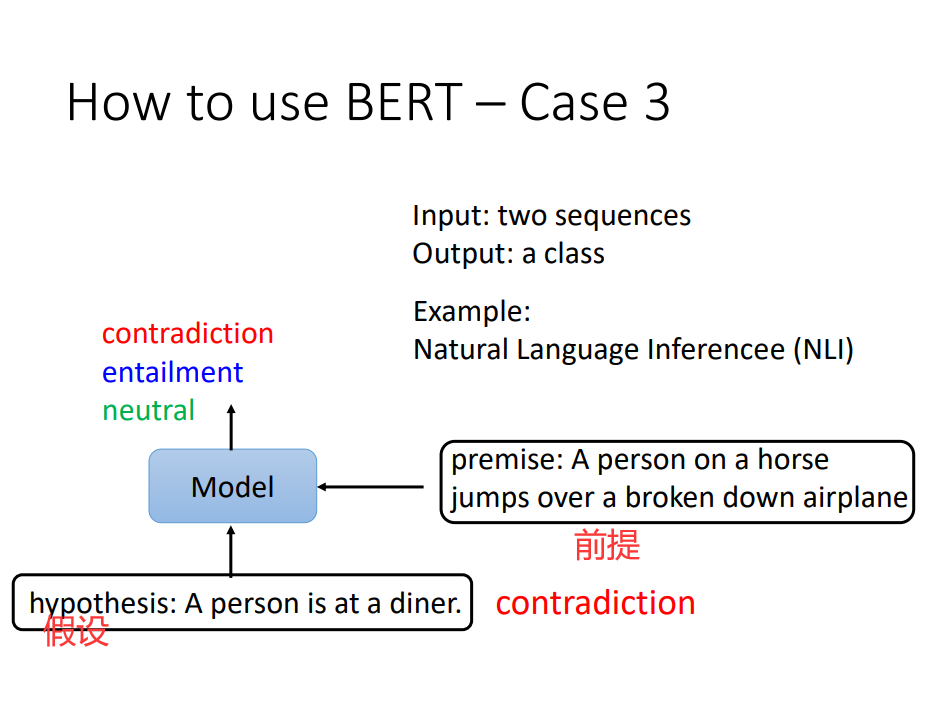
给它两个句子,我们在这两个句子之间放一个特殊的标记SEP,并在最开始放CLS标记。最终考察CLS标记对应的输出向量,将其放入Linear transform的输入得到分类。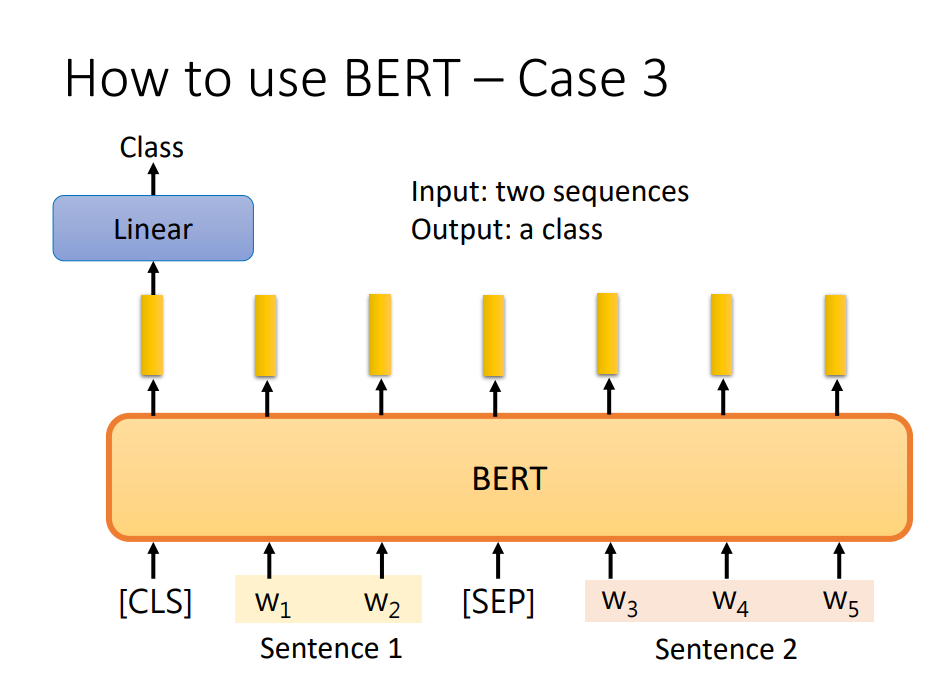
How to use BERT – Case 4 作业7问答系统
答案一定出现在文章里面
入序列包含一篇文章和一个问题,文章和问题都是一个序列。对于中文来说,每个d代表一个汉字,每个q代表一个汉字。你把d和q放入QA模型中,我们希望它输出两个正整数s和e。根据这两个正整数,我们可以直接从文章中截取一段,它就是答案。这个片段就是正确的答案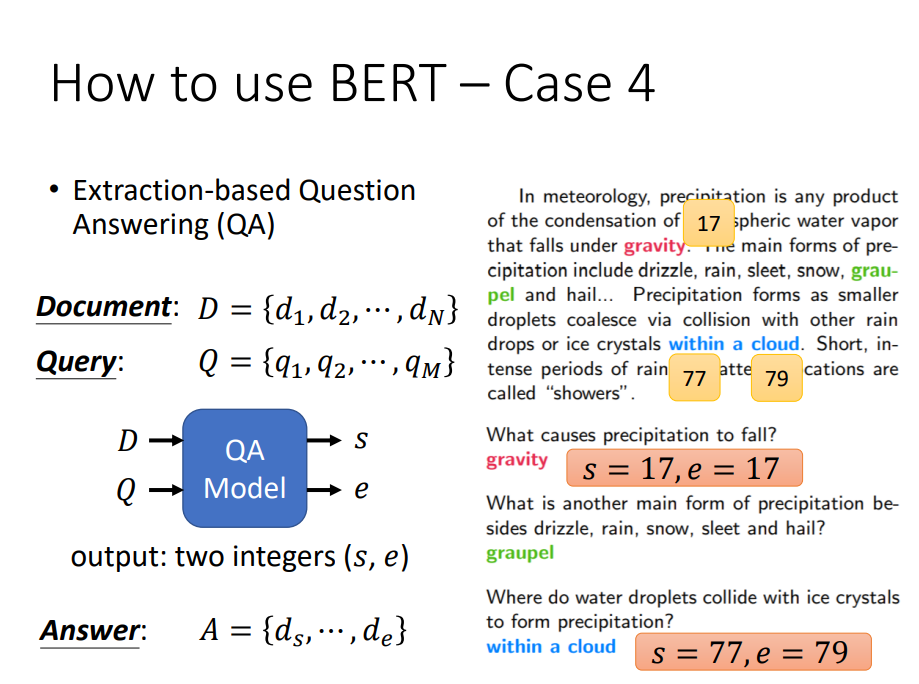
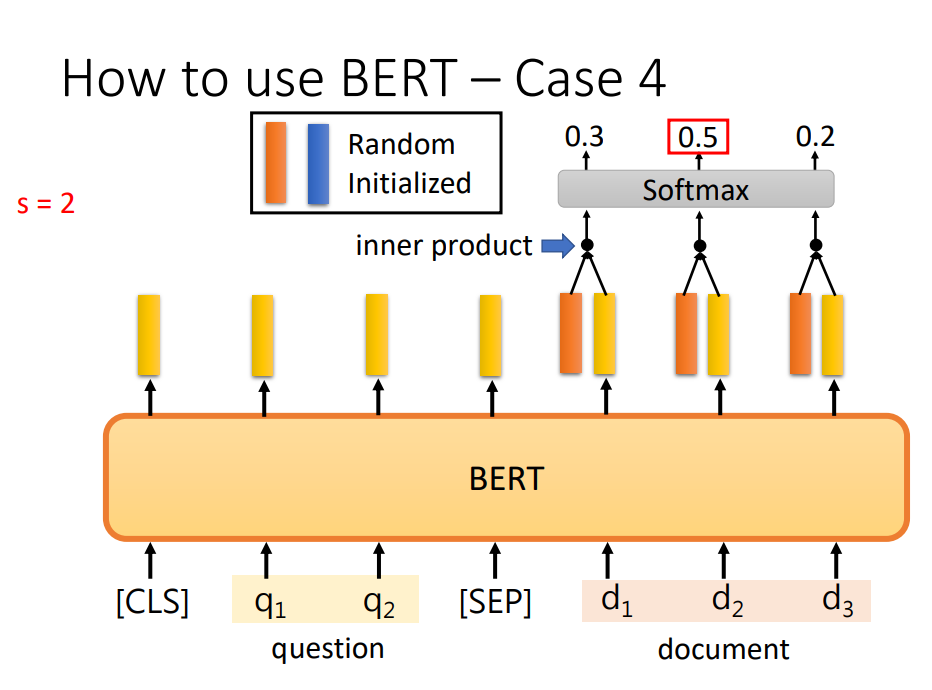
计算这个橙色向量和那些与document相对应的输出向量(黄色向量)的内积,计算内积,通过softmax函数,找到数值最大的位置,即为答案的开始位置。
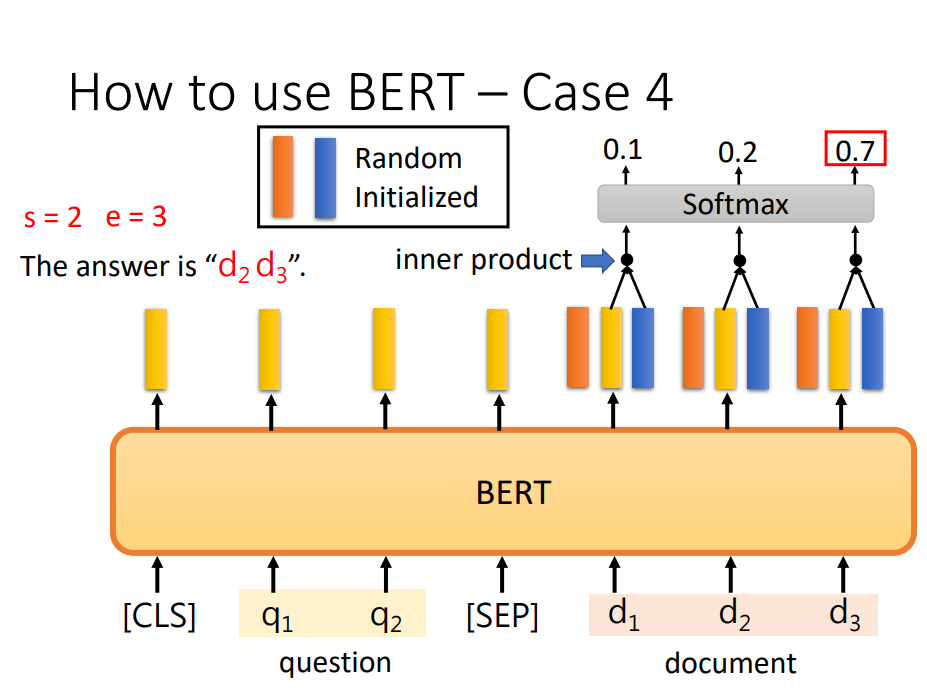
蓝色向量类似找到答案的结尾位置。
Why does BERT work?
每个文本都有一个对应的向量,称之为embedding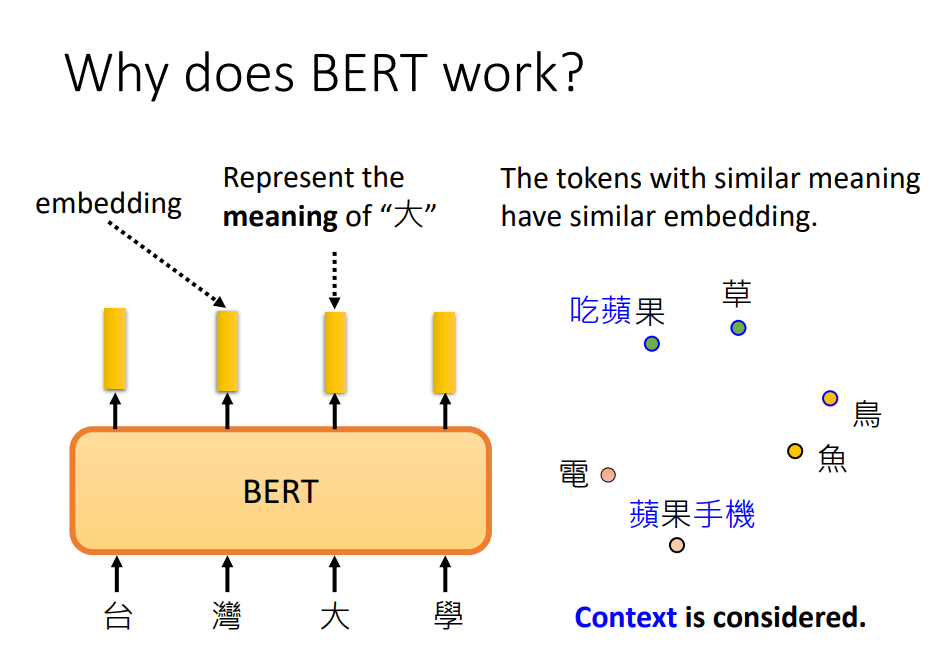
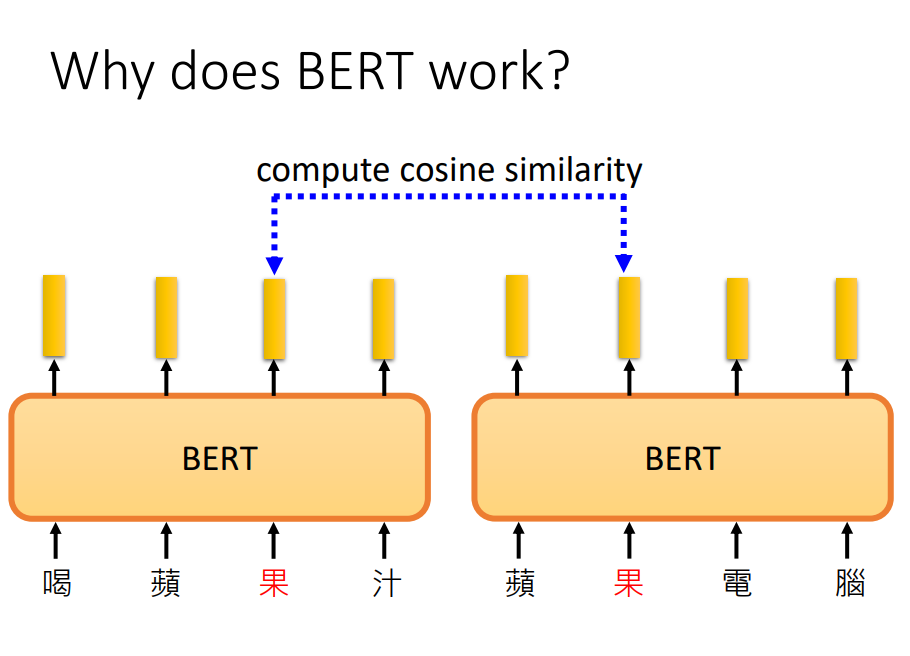
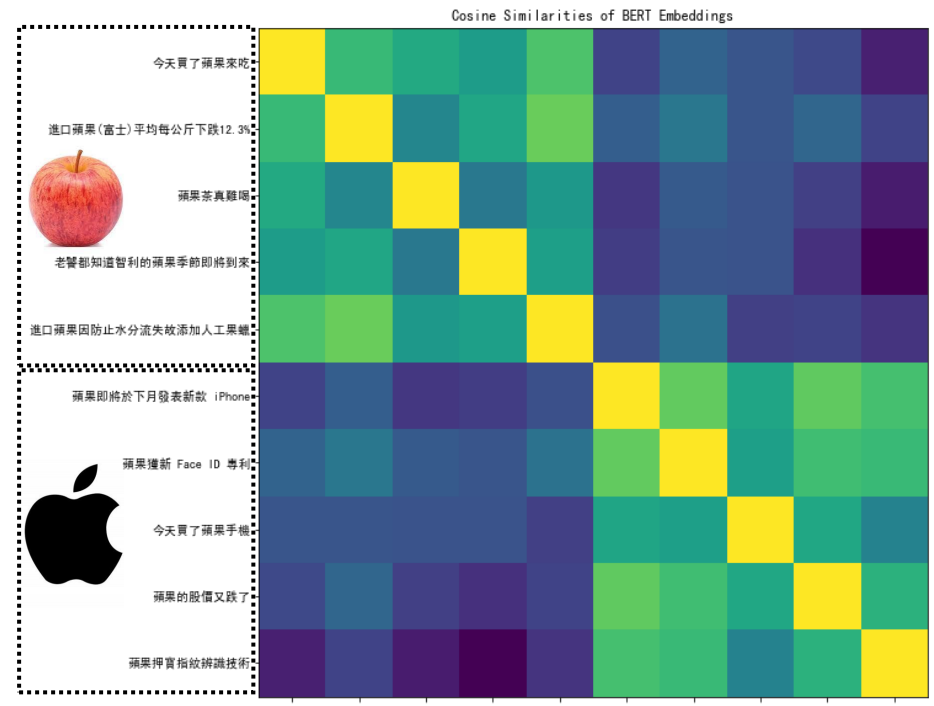
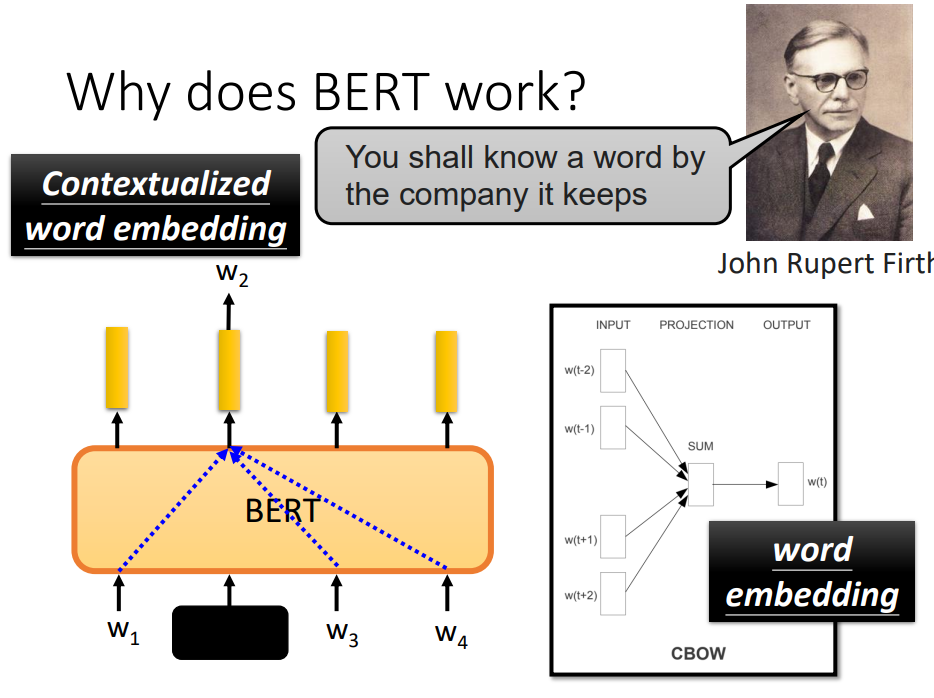
了解一次词汇取决于他的上下文。W2遮起来,看上下文预测W2。
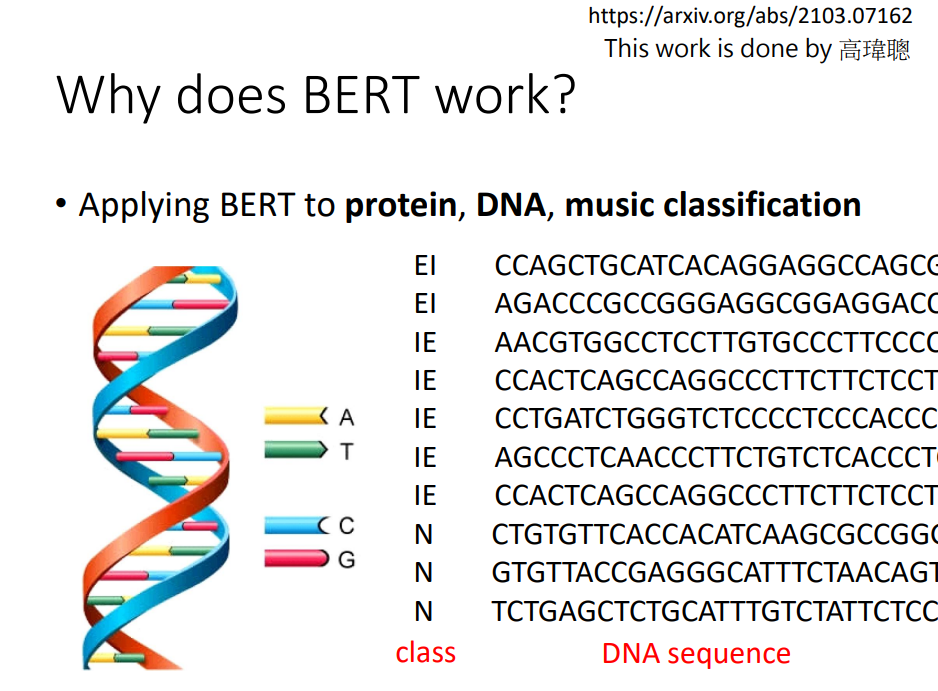
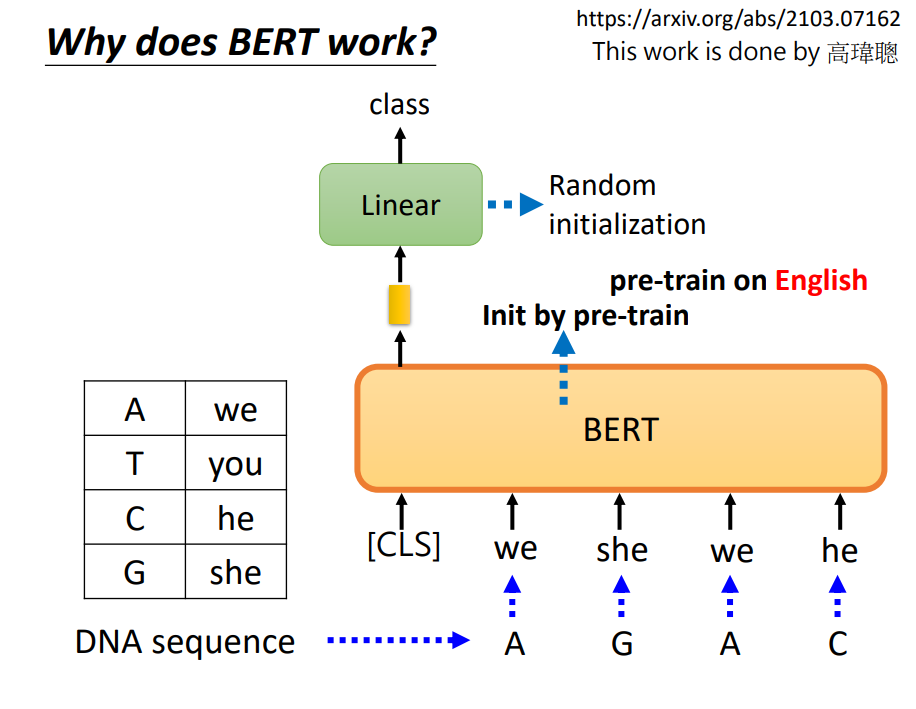
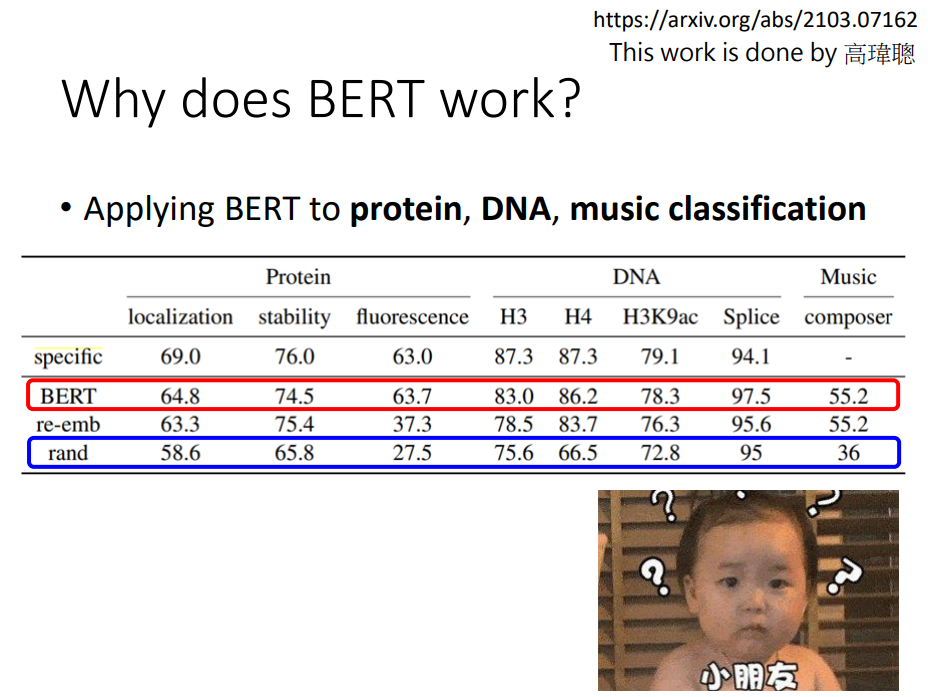
把一个DNA序列/蛋白质/音乐预处理成一个无意义的token序列,并使用BERT进行分类,也能得到比较好的结果。
Multi-lingual BERT
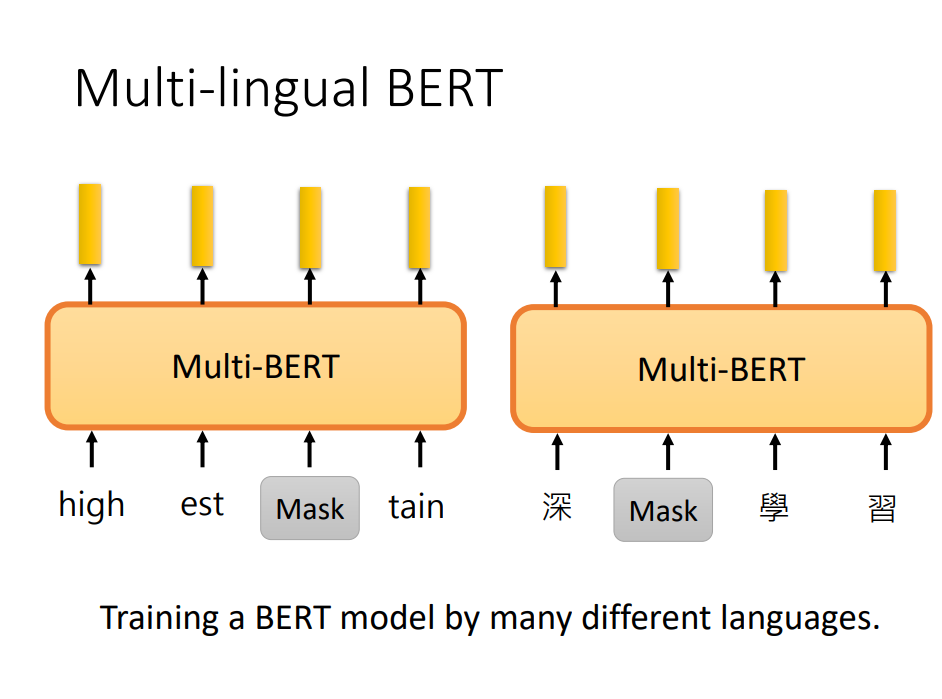
它是由很多语言来训练的,比如中文、英文、德文、法文等等,用填空题来训练BERT,这就是Multi-lingual BERT的训练方式。
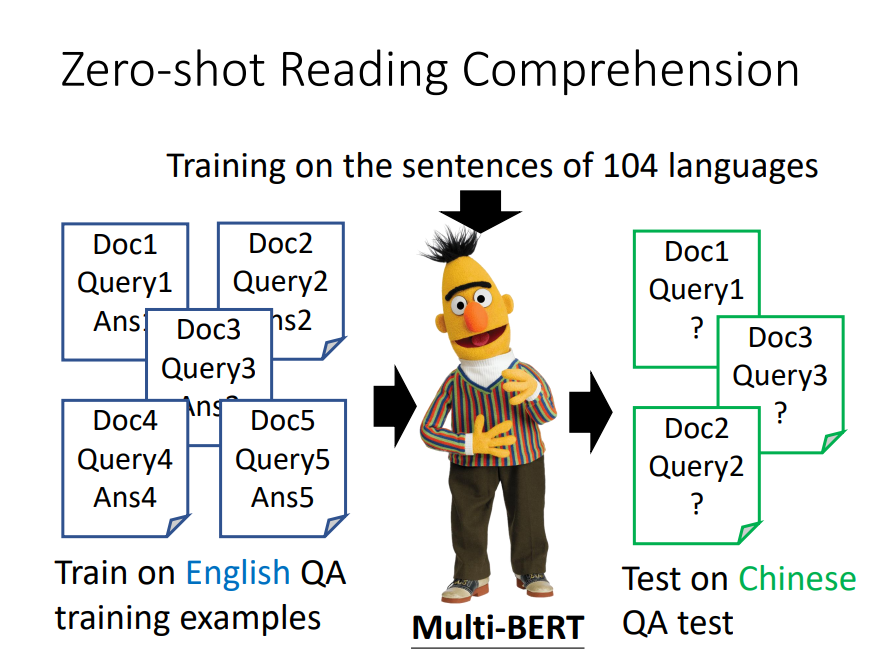
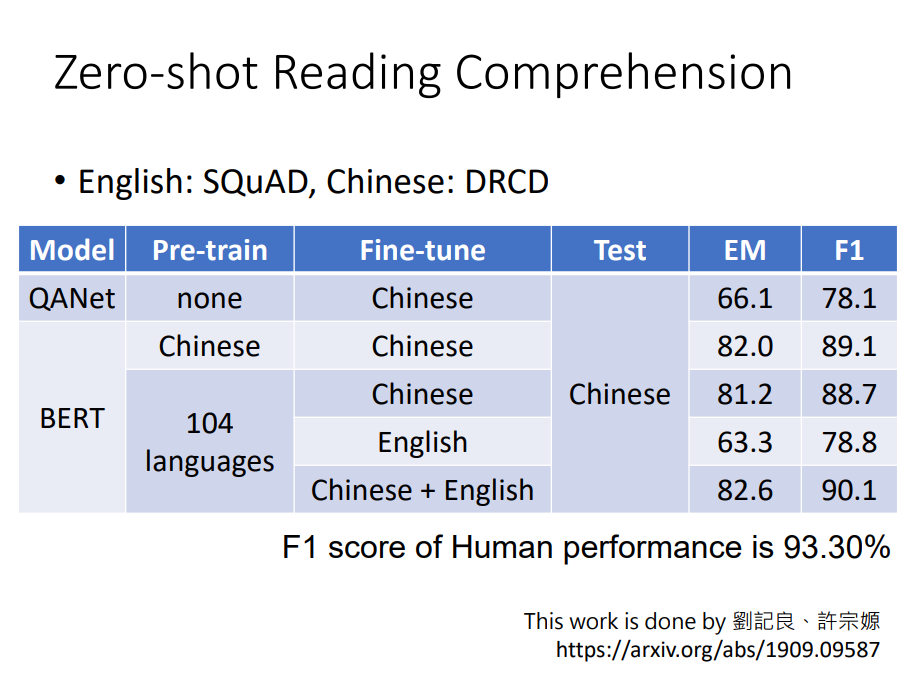
英文训练,能回答中文的测试集
原因: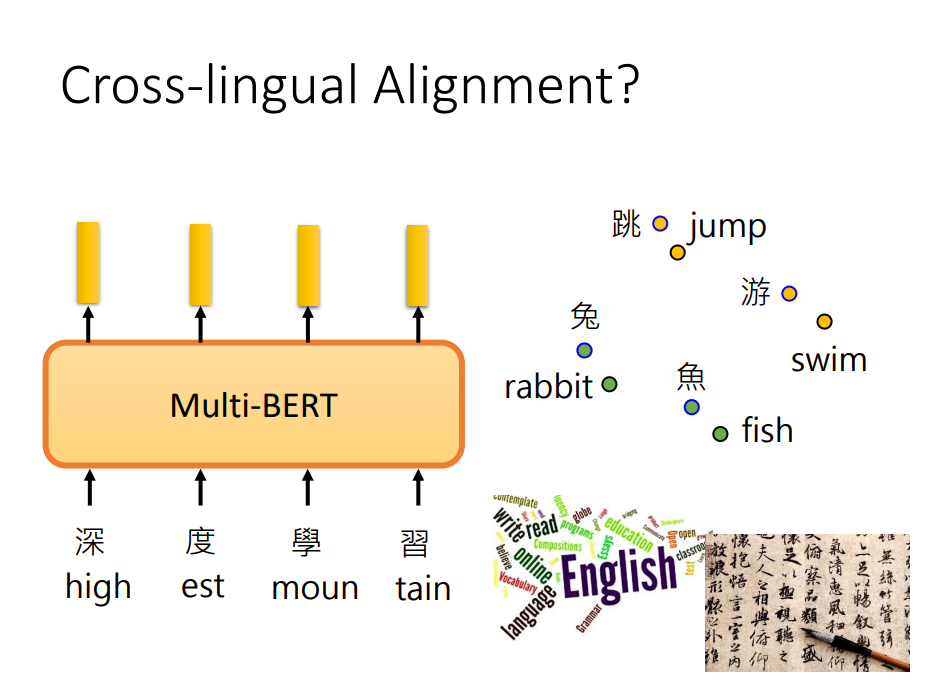
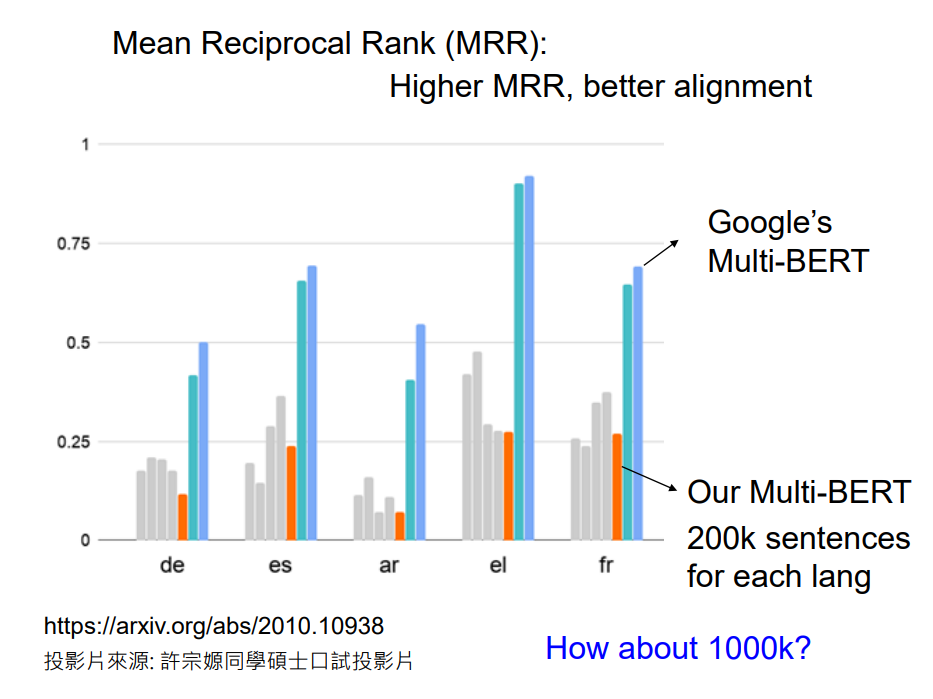
不同的语言并没有那么大的差异。无论你用中文还是英文显示,对于具有相同含义的单词,它们的embedding都很接近。
数据量是一个非常关键的因素。资源大才能够被观察到。
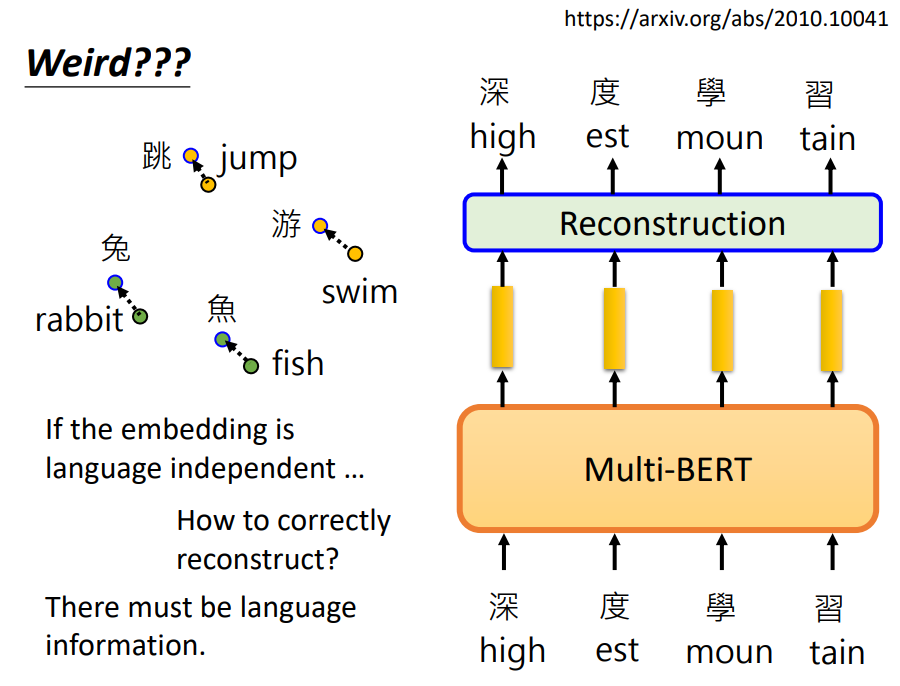
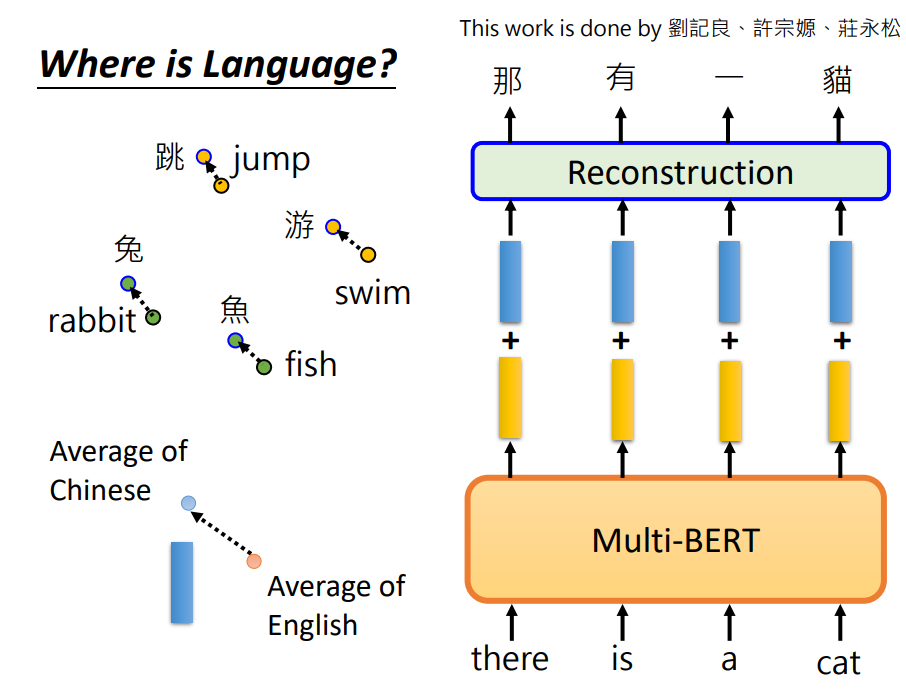
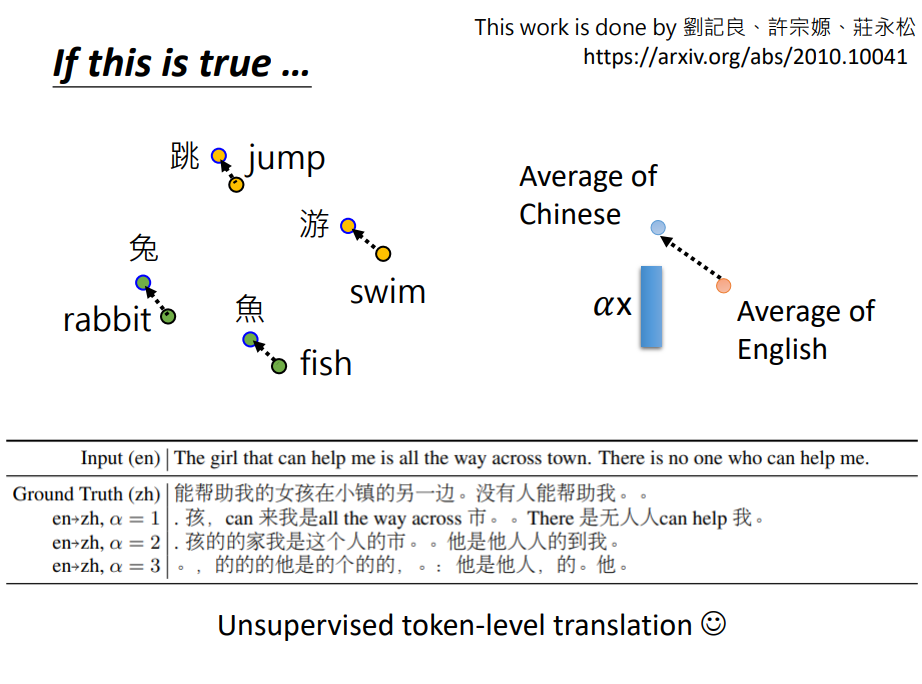
当训练多语言的BERT时,如果给它英语,它可以用英语填空,如果给它中文,它可以用中文填空,它不会混在一起,这说明它知道语言的信息也是不同的。
GPT系列模型
GPT要做的是接下来会出现的token是什么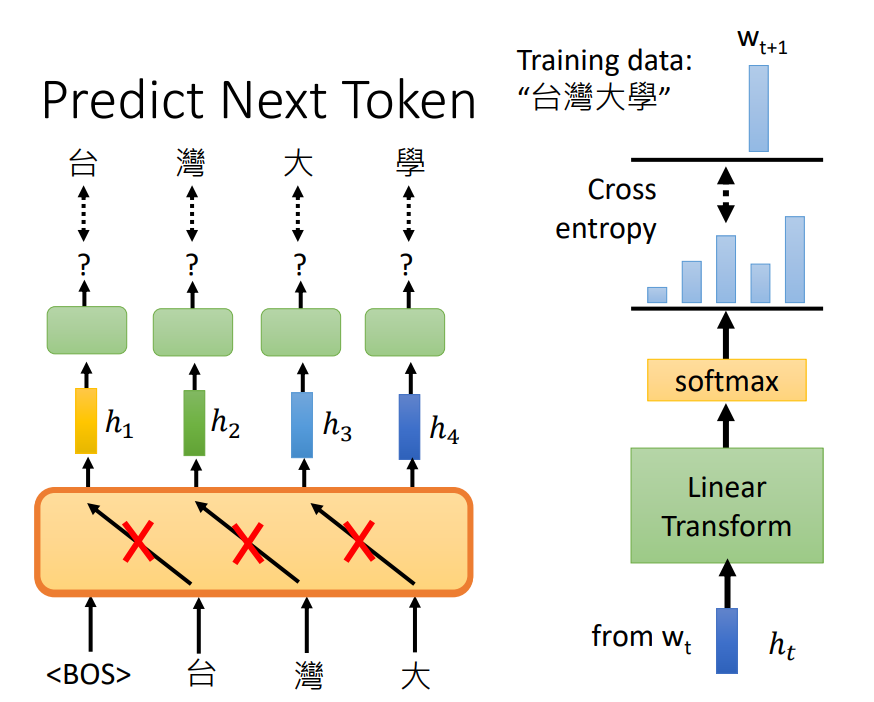
给个token,输出一个embedding名为h1,用这个embedding预测下一个出现的token是什么,根据这笔资料,下一个出现的应该是台。再拿台作为token去预测下一个。
GPT可以把一句话补完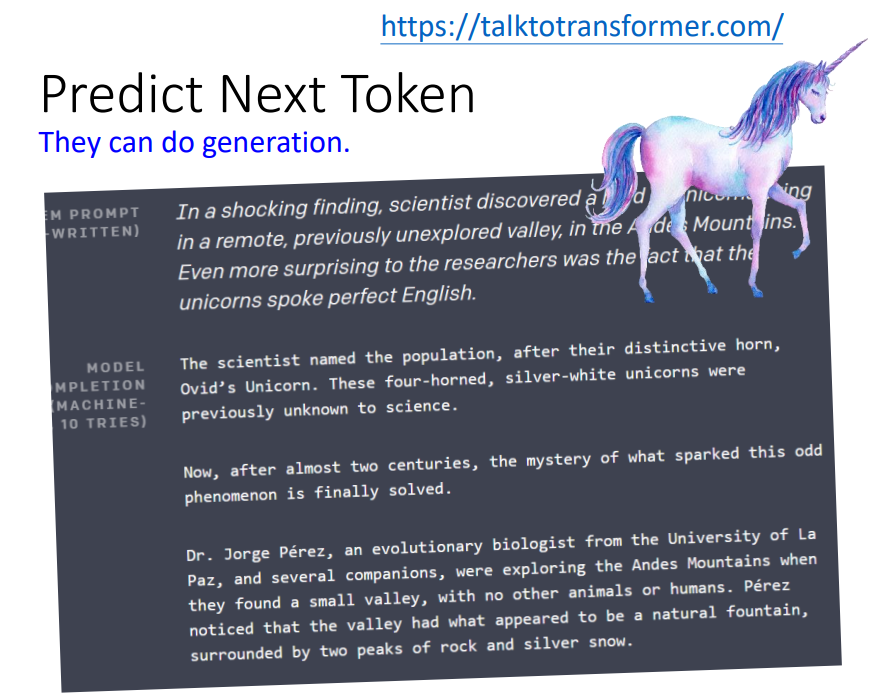
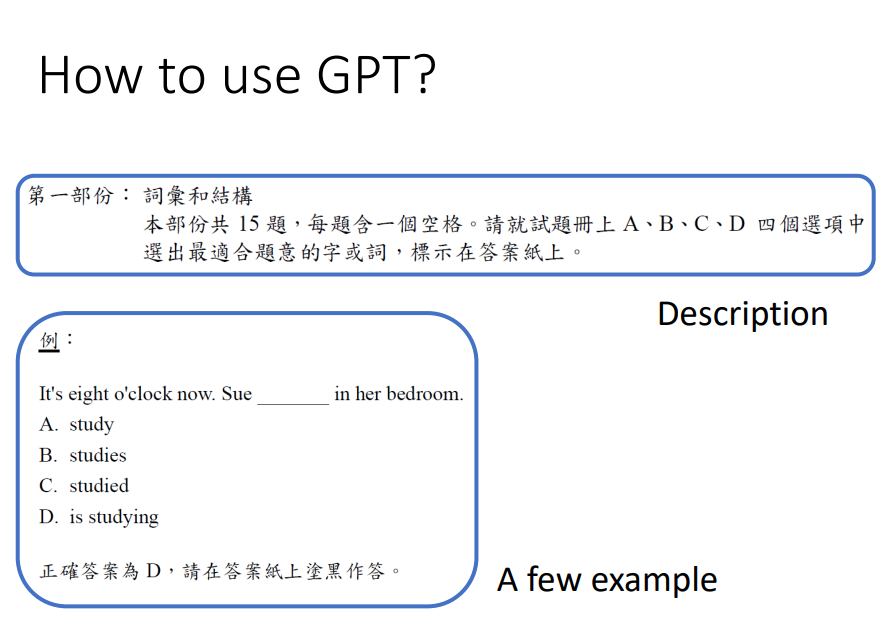
GPT给前半段文字,给几个例子做翻译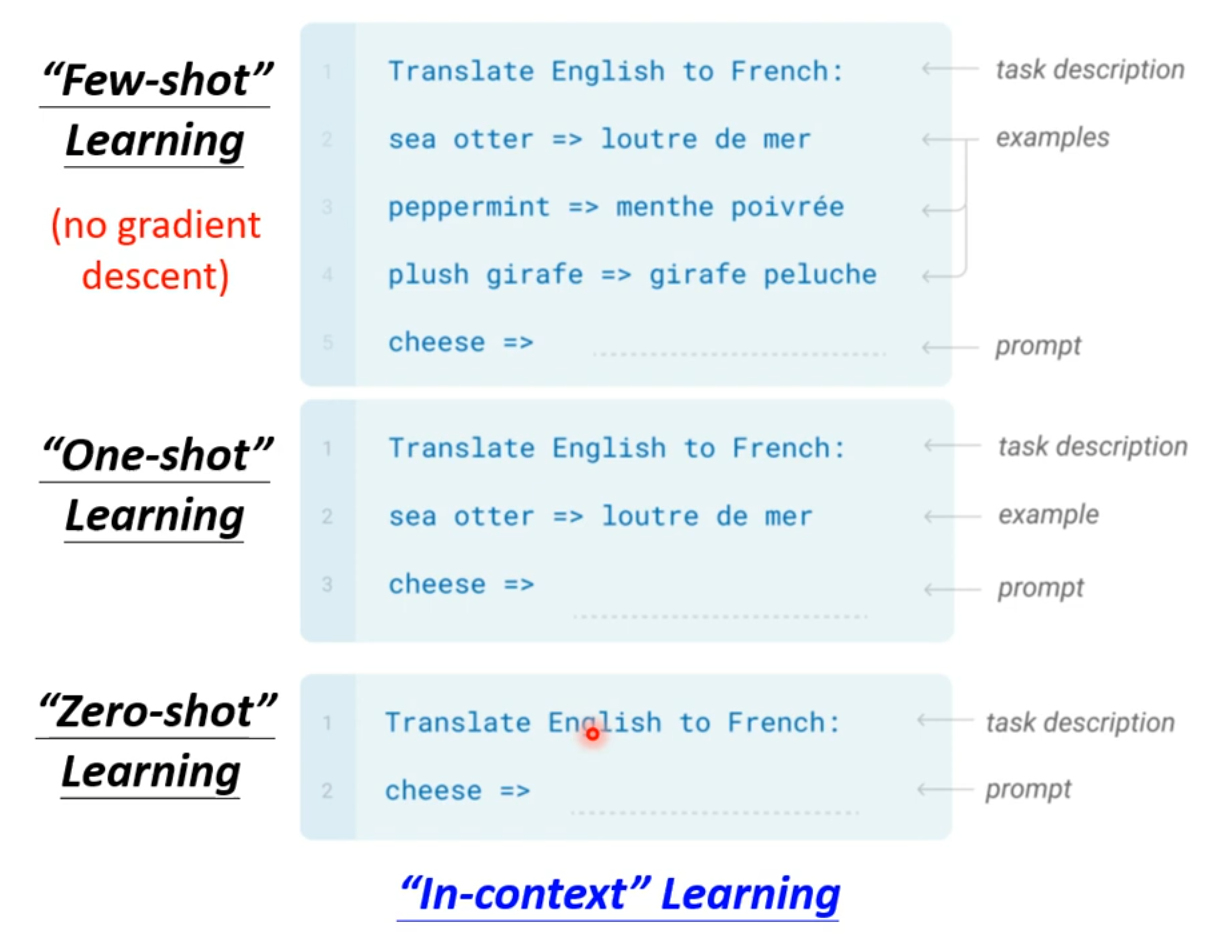
正确率有点低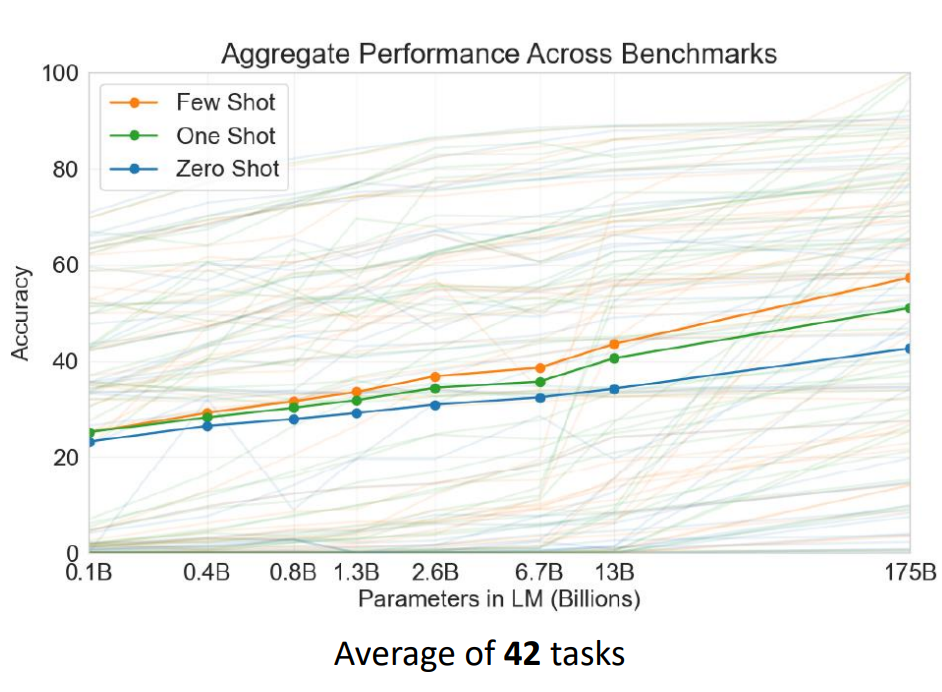
- 标题: NLP自监督学习
- 作者: moye
- 创建于 : 2022-08-16 15:01:08
- 更新于 : 2022-08-16 15:01:08
- 链接: https://www.kanes.top/2022/08/16/NLP自监督学习/
- 版权声明: 本文章采用 CC BY-NC-SA 4.0 进行许可。